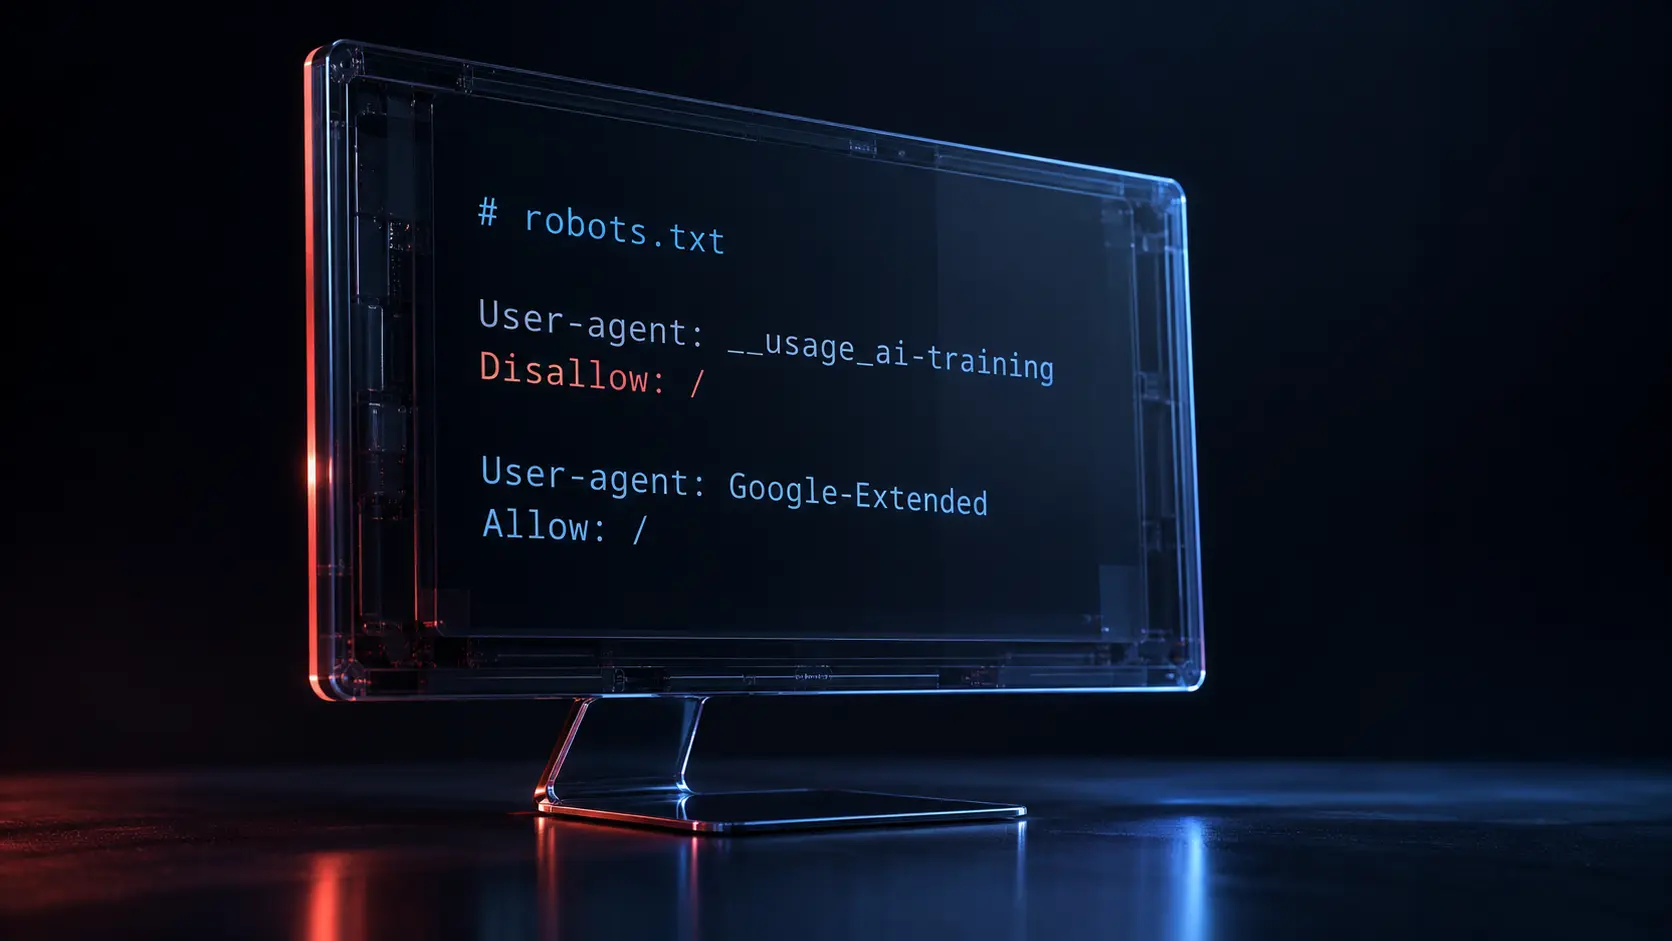
Google a annoncé le 30 octobre son intention d’adopter un contrôle partagé des préférences d’entraînement IA. Dans un billet signé par John Mueller, Search Advocate, l’entreprise a présenté un mécanisme issu des travaux du groupe AIPREF de l’Internet Engineering Task Force (IETF). Microsoft, OpenAI et Anthropic ont également annoncé leur soutien à cette démarche.
Une même instruction pour plusieurs fournisseurs d’IA
Aujourd’hui, les éditeurs doivent gérer des consignes distinctes pour les différents robots d’entraînement IA. Le nouveau mécanisme doit permettre d’exprimer un choix commun à plusieurs fournisseurs dans le fichier robots.txt.
Il repose sur le jeton __usage_ai-training, placé dans une ligne User-agent. Un refus applicable à l’ensemble du site prendrait cette forme.
User-agent: __usage_ai-training
Disallow: /
Cette instruction exprime une préférence contre l’utilisation des contenus pour entraîner des modèles génératifs. Elle ne désigne pas un nouveau robot et ne bloque pas automatiquement l’exploration. Le projet distingue les préférences d’usage des règles de contrôle du crawl.
Google-Extended restera prioritaire s’il est explicitement défini
Google a précisé comment il compte interpréter ce signal. Si un site refuse l’entraînement avec le jeton commun, sans consigne explicite pour Google-Extended, l’entreprise traitera ce choix comme un refus de Google-Extended.
Les éditeurs pourront conserver des consignes propres à Google, en complément de leur préférence générale. Une autorisation explicite de Google-Extended permettra ainsi de maintenir l’éligibilité des contenus aux réponses fondées sur le Web dans les applications Gemini.
Cette articulation dépasse le seul entraînement. Google-Extended régit aussi le grounding, c’est-à-dire l’utilisation de contenus pour documenter une réponse au moment d’une requête, dans Gemini Apps et certains services Vertex AI. En revanche, il ne modifie pas le classement ni l’inclusion du site dans Google Search.
Une adoption volontaire avant la finalisation du standard
La documentation de Google prévoit une prise en charge au début de l’année 2027. OpenAI a annoncé une mise en œuvre dans les prochains mois, avec le maintien de ses contrôles actuels. Microsoft a fixé au 1er février 2027 l’application de ses nouvelles préférences.
Le mécanisme repose encore sur un projet de spécification individuel, déposé le 30 octobre par Kevin Kelley, d’Anthropic. Il ne constitue pas une norme approuvée par l’IETF. Son adoption annoncée par les fournisseurs reste volontaire.
Le projet permet aussi de définir des préférences par chemin. Un éditeur pourrait donc refuser l’entraînement IA pour l’ensemble de son site, puis autoriser cet usage pour un répertoire précis avec une règle Allow.