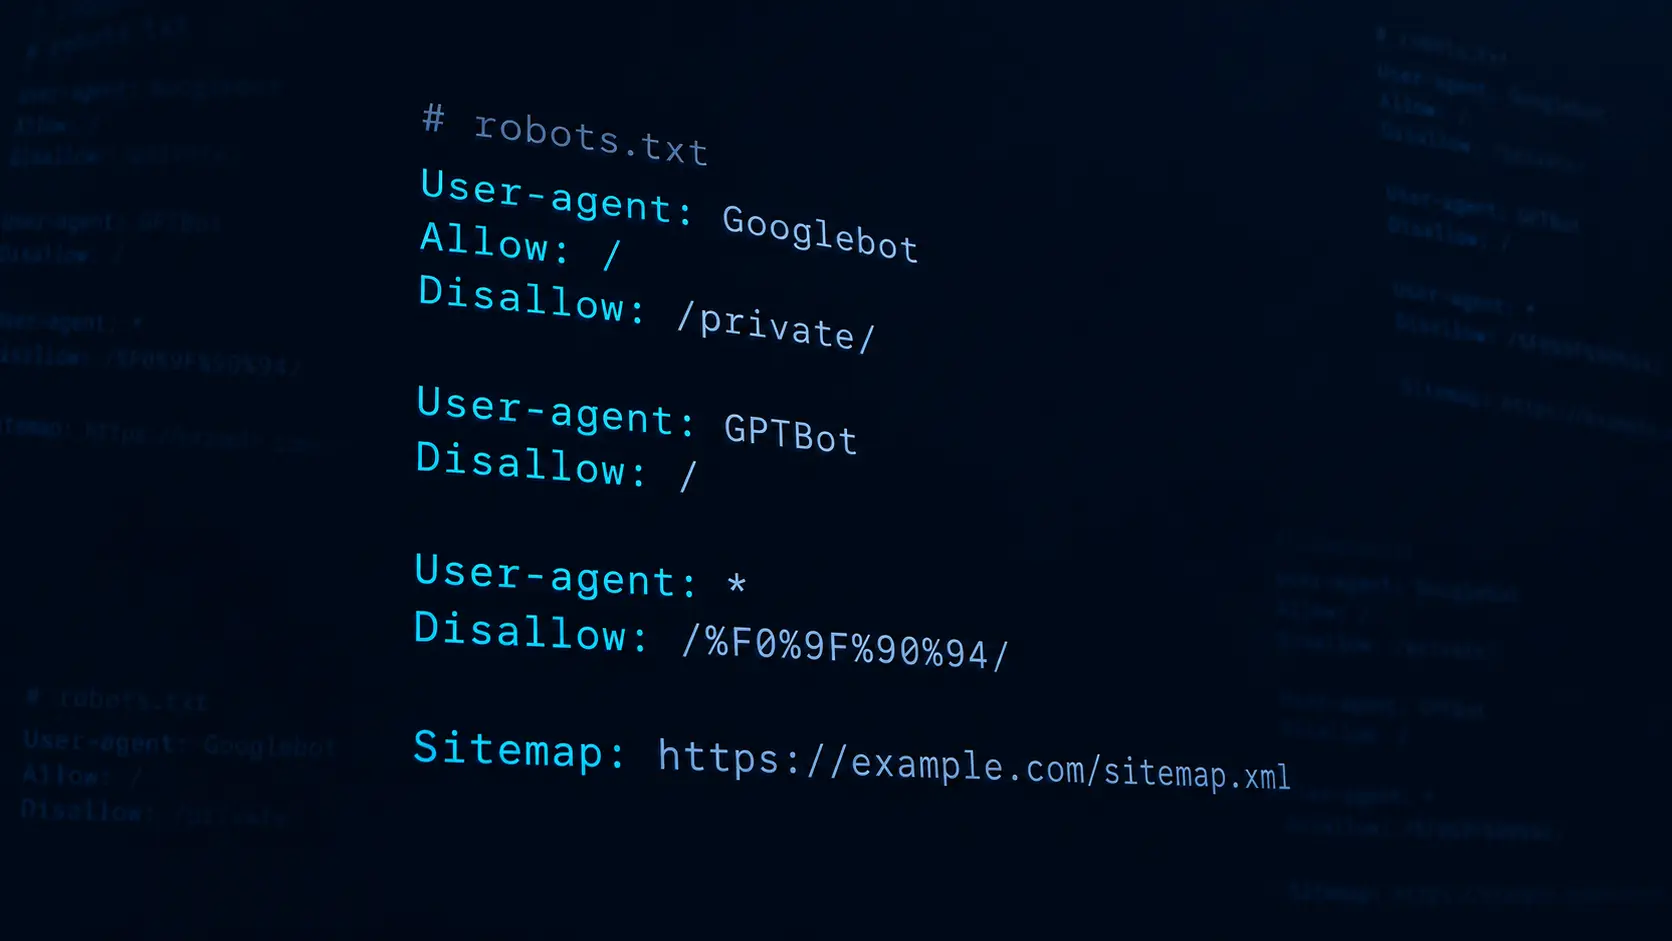
Gary Illyes et Cherry Prommawin, de l’équipe Google Search Relations, consacrent le deuxième épisode de The Non-Canonical Cabinet au fichier robots.txt. Après les caractères et mots-clés dans les URL, les deux intervenants expliquent quelles instructions les robots peuvent interpréter.
Une syntaxe précise pour les règles d’exploration
Placé à la racine du site, robots.txt indique aux robots qui respectent le protocole quelles URL ils peuvent explorer. Son fonctionnement repose sur la norme internet RFC 9309.
Google attend un fichier texte encodé en UTF-8. Le champ User-agent désigne le robot concerné, tandis que Allow et Disallow définissent les chemins autorisés ou interdits à l’exploration des sites. Le champ Sitemap, également pris en charge par Google, indique l’adresse d’un sitemap.
Les lignes non reconnues sont ignorées. Une phrase comme « ne pas explorer cette page » ne remplace donc pas une directive valide. Les commentaires, introduits par #, sont eux aussi écartés lors de l’interprétation des règles.
Google recommande l’encodage des caractères internationaux
Les chemins d’URL peuvent contenir des lettres accentuées, des caractères chinois ou arabes, ainsi que des emojis. Le traitement de ces caractères dans les URL doit rester cohérent avec celui du serveur.
Google accepte les chemins en UTF-8 brut et leur forme encodée. Son analyseur convertit automatiquement les caractères bruts avant de comparer les règles aux adresses. Pour Google, les deux écritures sont donc acceptées.
La vidéo recommande néanmoins la forme encodée dans les règles, car d’autres robots peuvent traiter différemment les caractères internationaux. L’emoji poule, par exemple, correspond à %F0%9F%90%94.
Cette possibilité concerne les chemins. Un emoji ne peut pas servir d’identifiant de robot dans le champ User-agent.
Robots.txt contrôle le crawl, pas l’usage ultérieur des données
Pour interdire l’accès à un robot IA précis, la règle doit viser l’identifiant reconnu du robot concerné dans User-agent. Un nom inventé ou une consigne rédigée en langage naturel ne permet pas de le cibler.
Les intervenants distinguent l’accès aux pages et l’entraînement des modèles. Le protocole standard indique quels chemins un robot peut explorer. Il ne définit pas ce qu’un système peut faire des données après leur collecte.
Les éditeurs de robots documentent leurs propres identifiants et leurs fonctions, comme les user-agents publiés par OpenAI. La règle doit correspondre au robot dont le site souhaite contrôler l’accès.